Primerjava vodilnih jezikovnih modelov za 3D generiranje
Posodobljeno oktobra 2026. Zapis je nastal novembra 2025 kot spopad treh modelov: GPT-5, GPT-5.1 in Gemini 3. Od takrat sem nabor testov pognal na več kot tridesetih kombinacijah modelov in nastavitev, privzeti model pa zamenjal šestkrat. Na začetku je zdajšnja razvrstitev, prvotne številke iz novembra 2025 pa so ostale na koncu, kot posnetek tistega časa.
Za GrandpaCAD, moje orodje za 3D modele iz besedila, mora jezikovni model odgovoriti na eno samo vprašanje. Ali zna napisati CAD kodo, ki se prevede v natisljiv predmet, kakršnega je uporabnik hotel? In to hitro, ne da bi me stalo več, kot mi je uporabnik plačal? Javne lestvice tega ne merijo, zato imam svoje teste.
Kako testiram danes
Nabor predvaja 23 scenarijev skozi produkcijskega klepetalnega agenta s pravimi CAD orodji, nič ni simulirano. Trinajst scenarijev je delov v enem koraku (kozarec z navojem, ohišje za Pi 4, kavelj za perforirano ploščo, šahovska kraljica, skodelica za kavo). V petih uporabnik del izpopolnjuje čez več sporočil (stojalo za telefon, stolp za kocke, ptičja hišica). Štirje preverjajo urejanje parametrov, zadnji pa združi organski model s CAD-om. Če generirana koda vrže napako, se ta vrne modelu, ki v istem koraku poskusi znova, natanko tako kot v pravi seji. Lestvica za ocenjevanje je opisana v zapisu o metodologiji.
Od leta 2025 so se spremenile tri stvari. Prvič, vsak zagon ocenim sam, ročno, na lestvici skladnosti od 0 do 1. Prej je ocenjeval drug model, dokler ga nisem primerjal s sedmimi zagoni, ki sem jih v celoti ocenil sam. Sodnik je precenil vse po vrsti, najbolj pa najslabše modele: najšibkejšega za 0,27, najmočnejšega za 0,05. Razvrstitev po njegovih ocenah je bila skoraj obratna od moje, zato sem ga izklopil. Drugič, vsak scenarij ima deterministična preverjanja, o katerih se ni mogoče prepirati. Je datoteka nastala? Koliko napak je bilo v kodi? Sta strošek in čas ostala v okviru? Tretjič, vsak zagon za vsak model beleži strošek in čas od začetka do konca. Prav ti dve številki na koncu odločita, kaj gre v produkcijo.
Oktober 2026: trenutna razvrstitev
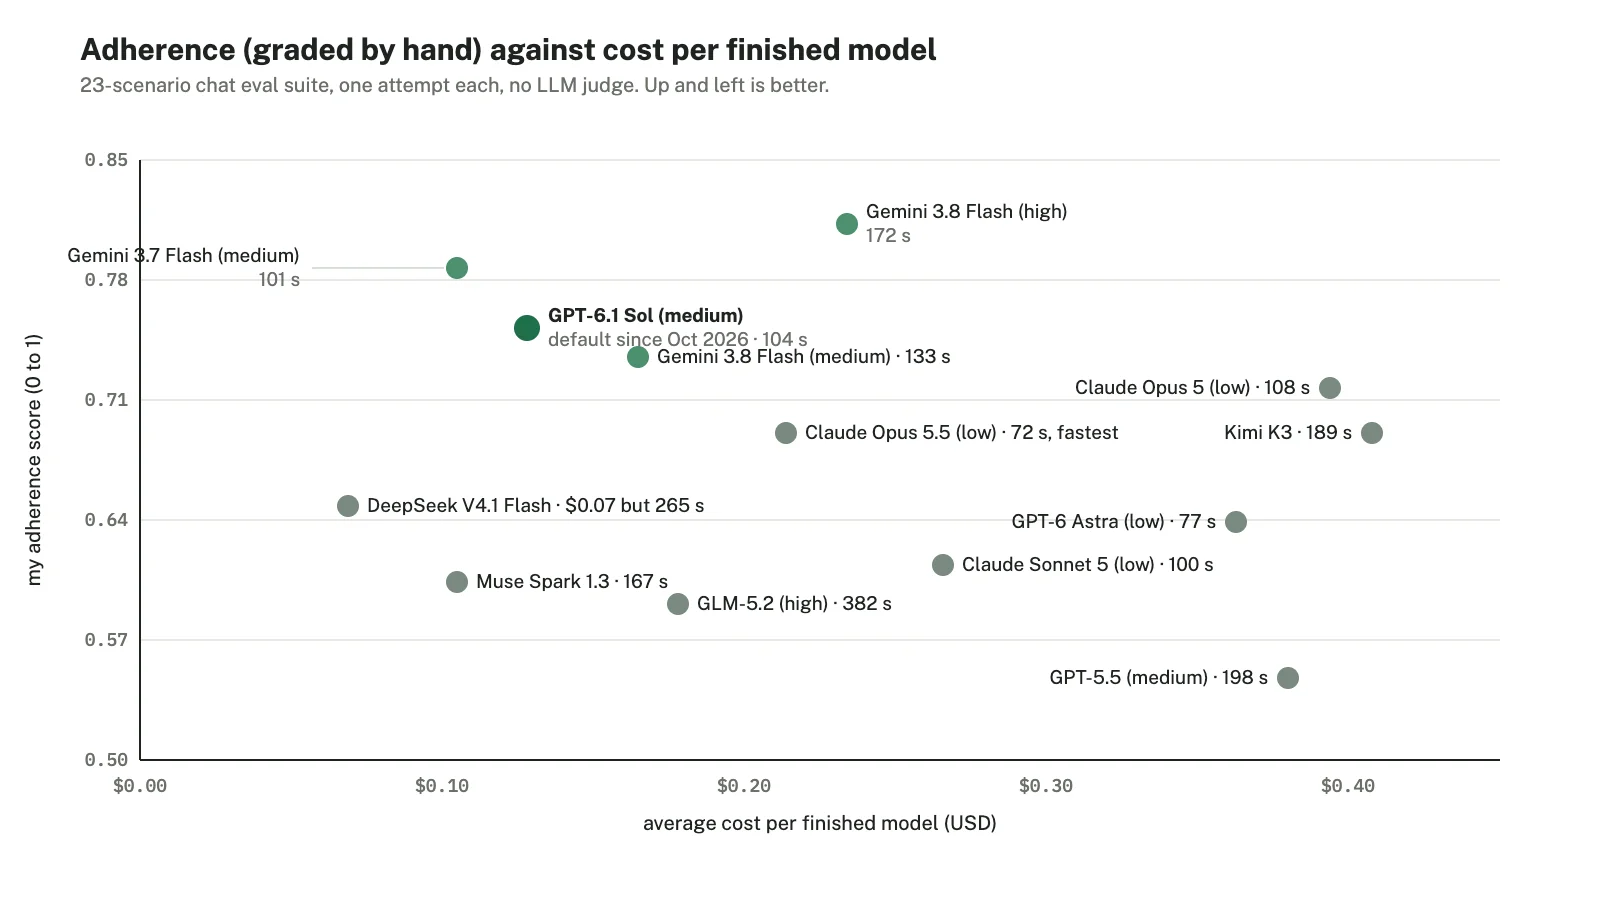
Vsaka točka spodaj je en celoten prehod nabora: vsak scenarij en poskus, vse ocenjeno ročno. Strošek je povprečje na dokončan model, ponovni poskusi so všteti. Čas je povprečje od prompta do datoteke.
| Model (napor sklepanja) | Skladnost | Uspešna preverjanja | Napake v kodi | Povpr. strošek | Povpr. čas |
|---|
| GPT-6.1 Sol (srednji)privzet od oktobra 2026 | 0,75 | 91/106 | 1 | 0,13 $ | 1 min 44 s |
| Gemini 3.8 Flash (visok) | 0,81 | 87/106 | 8 | 0,23 $ | 2 min 52 s |
| Gemini 3.7 Flash (srednji)privzet avgusta in septembra 2026 | 0,79 | 97/106 | 10 | 0,11 $ | 1 min 41 s |
| Gemini 3.8 Flash (srednji) | 0,74 | 90/106 | 9 | 0,17 $ | 2 min 13 s |
| Claude Opus 5 (nizek, neposredno prek Anthropica) | 0,72 | 87/106 | 1 | 0,39 $ | 1 min 48 s |
| Claude Opus 5.5 (nizek)najhitrejši | 0,69 | 93/106 | 10 | 0,21 $ | 1 min 12 s |
| Kimi K3 (nizek) | 0,69 | 84/106 | 8 | 0,41 $ | 3 min 9 s |
| DeepSeek V4.1 Flash (nizek)najcenejši | 0,65 | 89/106 | 13 | 0,07 $ | 4 min 25 s |
| GPT-6 Astra (nizek) | 0,64 | 93/106 | 1 | 0,36 $ | 1 min 17 s |
| Muse Spark 1.3 (srednji) | 0,60 | 87/106 | 3 | 0,11 $ | 2 min 47 s |
| GPT-5.5 (srednji)v 5 scenarijih ni nastal noben model | 0,55 | 71/106 | 3 | 0,38 $ | 3 min 18 s |
Pošteno moram dodati, da so zagoni potekali od junija do septembra 2026 in da so se v tem času prompti, veščine in orodja okrog agenta izboljšali. Dva prompta (šestkotni nosilec in kavelj za perforirano ploščo) sem zaostril tik pred zagoni GPT-6.1 Sol. Kasneje testirani modeli so imeli torej malo lažje delo. Razlike, o katerih pišem spodaj, so večje od tega zamika.
Zakaj je privzet GPT-6.1 Sol in ne Gemini 3.8 Flash
Če gledate samo stolpec skladnosti, zmaga Gemini 3.8 Flash z visokim naporom sklepanja. Njegovi modeli so mi bili najbolj všeč (0,81). V 23 scenarijih pa je osemkrat napisal kodo z napako, za vsak model porabil skoraj tri minute in stal skoraj dvakrat toliko kot GPT-6.1 Sol.
GPT-6.1 Sol se je zmotil enkrat. Enkrat, v celem naboru. Napaka v kodi ni abstraktna številka. Za njo je uporabnik, ki gleda vrtečo se ikono, medtem ko agent popravlja lastno skripto, in vsak popravek je še en klic modela. Kdor pri nas porabi svojo prvo brezplačno generacijo, naj raje dobi Sol s skladnostjo 0,75, eno napako, 0,13 $ in 1 min 44 s kot model z 0,81, ki se pred uporabnikom popravlja pri približno vsaki tretji generaciji.
Drugi razlog test zajame le deloma. Sol zgradi precej bolj zapletene stvari od vseh modelov pred njim: sestave iz več delov, ohišja z vsemi izrezi na pravih mestih, mehanizme, pri katerih se morajo deli ujeti. Na račun tega trpi domišljija. Na ohlapen opis dobite preprost, dobeseden del. Ta kompromis sem opisal v zapisu o zamenjavi, skupaj s prompti, ki ga pokažejo.
Gemini 3.7 Flash s srednjim naporom bi še vedno priporočil, če imate svoj cevovod in vas omejuje strošek. Ima najboljši delež determinističnih preverjanj v tabeli (97 od 106), stane 0,11 $ na model in je bil dva meseca naš privzeti model. Proti Solu ni izgubil zaradi cene, ampak zaradi napak v kodi (10 proti 1) in zaradi tega, kar zna zgraditi.
Česa me je naučilo leto testov
Več sklepanja redko pomaga, pogosto pa škodi. Gemini 3.7 Flash je z visokim naporom napake v kodi v prvem poskusu zbil z 10 na 3, pa je bil vseeno ocenjen slabše kot s srednjim, povrhu pa dražji in počasnejši. Claude Opus 5 je bil z visokim naporom v vsem slabši kot z nizkim. Nizki napor je bil 2,4-krat hitrejši, 28 % cenejši in brez ene same napake v kodi, visoki jih je naredil pet. Pri visokem sta dva scenarija celo obtičala na desetminutni časovni omejitvi. Že leta 2025 je GPT-5 s srednjim naporom premagal visokega za pol cene. Dodatno razmišljanje gre v razmišljanje, ne v del.
Prehod ni nevtralen. Isti Claude Opus 5 pri istem naporu je prek Anthropicovega API-ja stal 35 % manj kot prek OpenRouterja in bil cenejši v 22 od 23 scenarijev, kakovost pa je bila enaka. Zapis o Opusu 5 pokaže preizkus, ki pojasni, zakaj.
Napake v kodi bolje napovejo uporabniško izkušnjo kot moja ocena skladnosti. Skladnost pove, ali je končni del pravi. Napake v kodi povedo, koliko časa je uporabnik čakal in koliko klicev modela sem plačal, da je prišel do njega. Kadar sta dva modela pri skladnosti največ 0,05 narazen, odloči stolpec z napakami.
Javne lestvice se s to tabelo ne ujemajo nikoli. Aprila je bil Kimi K2.6 na vrhu javne 3D lestvice ELO, pri pravem delu pa zadnji. Opus 4.7 je bil na papirju počasen in drag, pa je prepričljivo zmagal. Tisti zapis našteje štiri načine, na katere javne številke lažejo. Od takrat me ni nič prepričalo v nasprotno.
Če želite kaj od tega preveriti, so vsi zagoni, tudi grdi, na strani z evalvacijami, s celotnim zapisom vsakega klica orodja.
Posnetek iz novembra 2025
Spodaj je prvotna različica zapisa, nespremenjena. Tekla je še na starem cevovodu z enim samim korakom (en prompt, ena generacija, brez agentske zanke), skladnost pa je namesto mene ocenjeval AI sodnik. Zato se te številke ne dajo primerjati s tabelo zgoraj.
GPT-5 (7. avgusta), GPT-5.1 (12. novembra) in Gemini 3 (19. novembra) so izšli v manj kot štirih mesecih. Vsakega sem pognal na 84 generacijah. Samo za Gemini 3 sem v prvih 24 urah po izidu pokuril 6 milijonov žetonov.
| Meritev | Gemini 3 | GPT-5 | GPT-5.1 |
|---|
| Tehtana ocena | 0,555 | 0,501 | 0,467 |
| Delež uspešnih | 79,76 % | 80,95 % | 67,86 % |
| Skladnost (AI sodnik) | 0,57 | 0,54 | 0,46 |
| Povpr. strošek | 0,14 $ | 0,18 $ | 0,26 $ |
| Povpr. čas | 1 min 24 s | 3 min 26 s | 1 min 12 s |
| Skupni strošek (84 zagonov) | 12,05 $ | 15,40 $ | 22,13 $ |
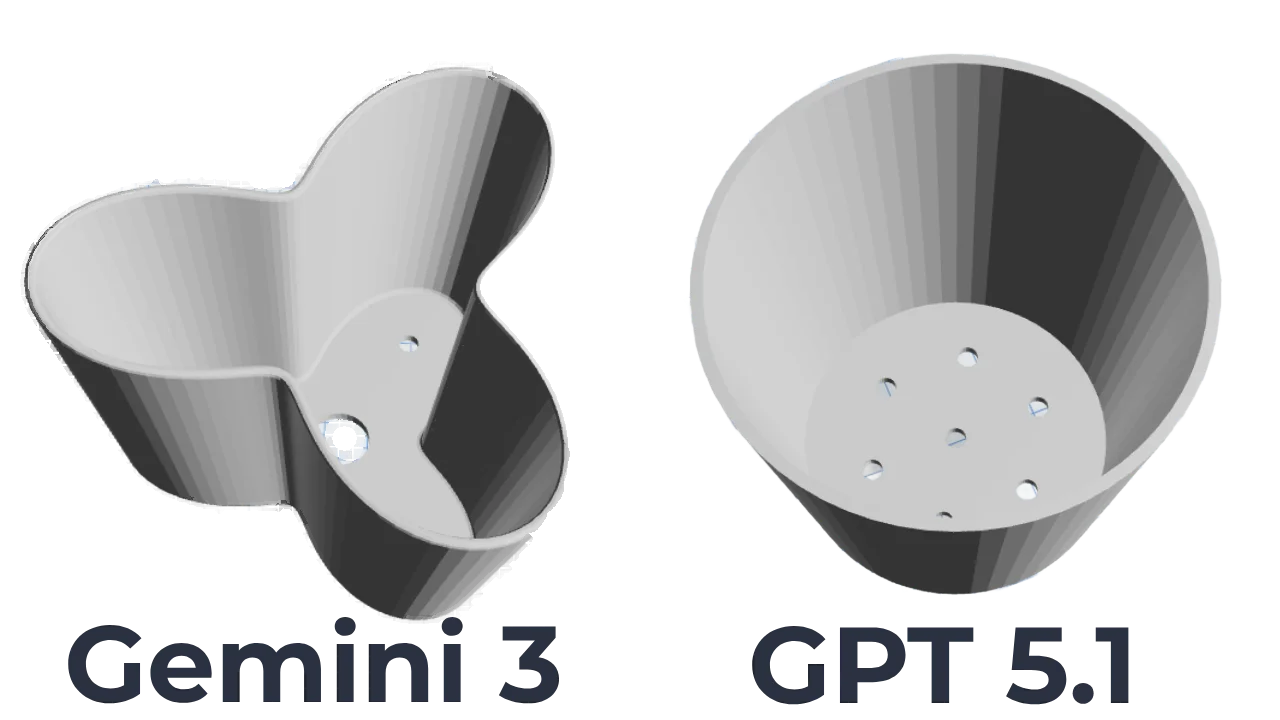
Gemini 3 je zmagal pri tehtani oceni, skladnosti in strošku, pa tudi občutek je bil drugačen. Ko sem zahteval »lonček za rože, ki se ga da zlagati v stolp«, so mi starejši modeli dali valj z robom, Gemini 3 pa nekaj, kar bi res zložil v stolp. GPT-5.1 je bil hiter, a je tekel na OpenAI-jevi prednostni ravni, ki mu je za 20 do 30 % večjo hitrost podvojila ceno, delež uspešnih pa mu je padel na 67,86 %. GPT-5 je imel najboljši delež uspešnih, a je za vsak model porabil več kot tri minute.
Kliknite sliko, da si model ogledate od blizu.
Gemini 3 je še isti teden postal privzeti model. Zdržal je do Gemini 3.1 marca 2026, ta do Opusa 4.7 aprila, potem sta prišla Gemini 3.6 Flash julija in Gemini 3.7 Flash avgusta. Lestvica se hitro spreminja in sproti ji lahko sledim samo tako, da nabor poganjam znova in znova.
Bi radi izvedeli za naslednjo primerjavo, takoj ko izide?
Ali pa preizkusite zmagovalca.