Comparatif des LLM de pointe pour la génération 3D
Mis à jour en octobre 2026. Cet article est né en novembre 2025 d'un match à trois entre GPT-5, GPT-5.1 et Gemini 3. Depuis, j'ai fait passer ma batterie de tests à plus de trente combinaisons de modèles et de réglages, et j'ai changé six fois de modèle par défaut. Le classement actuel vient en premier ; les chiffres de novembre 2025 sont conservés à la fin, tels quels, comme un instantané de l'époque.
Pour GrandpaCAD, mon outil texte vers 3D, je n'attends qu'une chose d'un modèle de langage. Qu'il écrive du code de CAO qui, une fois compilé, donne l'objet imprimable que l'utilisateur a demandé, rapidement, et sans me coûter plus que ce que l'utilisateur a payé. Les benchmarks publics ne mesurent pas ça, alors je fais les miens.
Comment se déroule le test aujourd'hui
La batterie rejoue 23 scénarios dans l'agent du chat en production, avec les vrais outils de CAO et rien de simulé. On y trouve treize pièces demandées d'un seul coup (un bocal fileté, un boîtier pour Pi 4, un crochet pour panneau perforé, une dame d'échecs, une tasse à café), cinq constructions en plusieurs messages où l'utilisateur affine la pièce au fil de la conversation (un support de téléphone, une tour à dés, un nichoir), quatre parcours de modification de paramètres et une pièce qui combine organique et CAO. Quand le code généré plante, l'erreur repart vers le modèle, qui réessaie dans le même tour, exactement comme dans une vraie session. Le barème est détaillé dans l'article sur la méthode.
Trois choses ont changé depuis 2025. D'abord, je note moi-même chaque run, à la main, sur une échelle de fidélité de 0 à 1. Avant, je laissais un second modèle faire office de juge, jusqu'au jour où je l'ai confronté à sept runs entièrement notés par un humain. Il surnotait tous les runs, et c'est sur les pires modèles qu'il exagérait le plus (0,27 de trop pour le plus faible, 0,05 pour le meilleur). Classer les modèles selon sa note donnait à peu près l'inverse du classement humain, alors le juge est débranché. Ensuite, chaque scénario comporte des vérifications automatiques qu'aucun avis ne peut contester : un fichier est-il sorti, combien d'erreurs de code, le budget de coût et de temps a-t-il été tenu ? Enfin, chaque run enregistre le coût et la durée réelle par modèle, et c'est ça qui décide, au bout du compte, de ce que je mets en production.
Octobre 2026 : le classement actuel
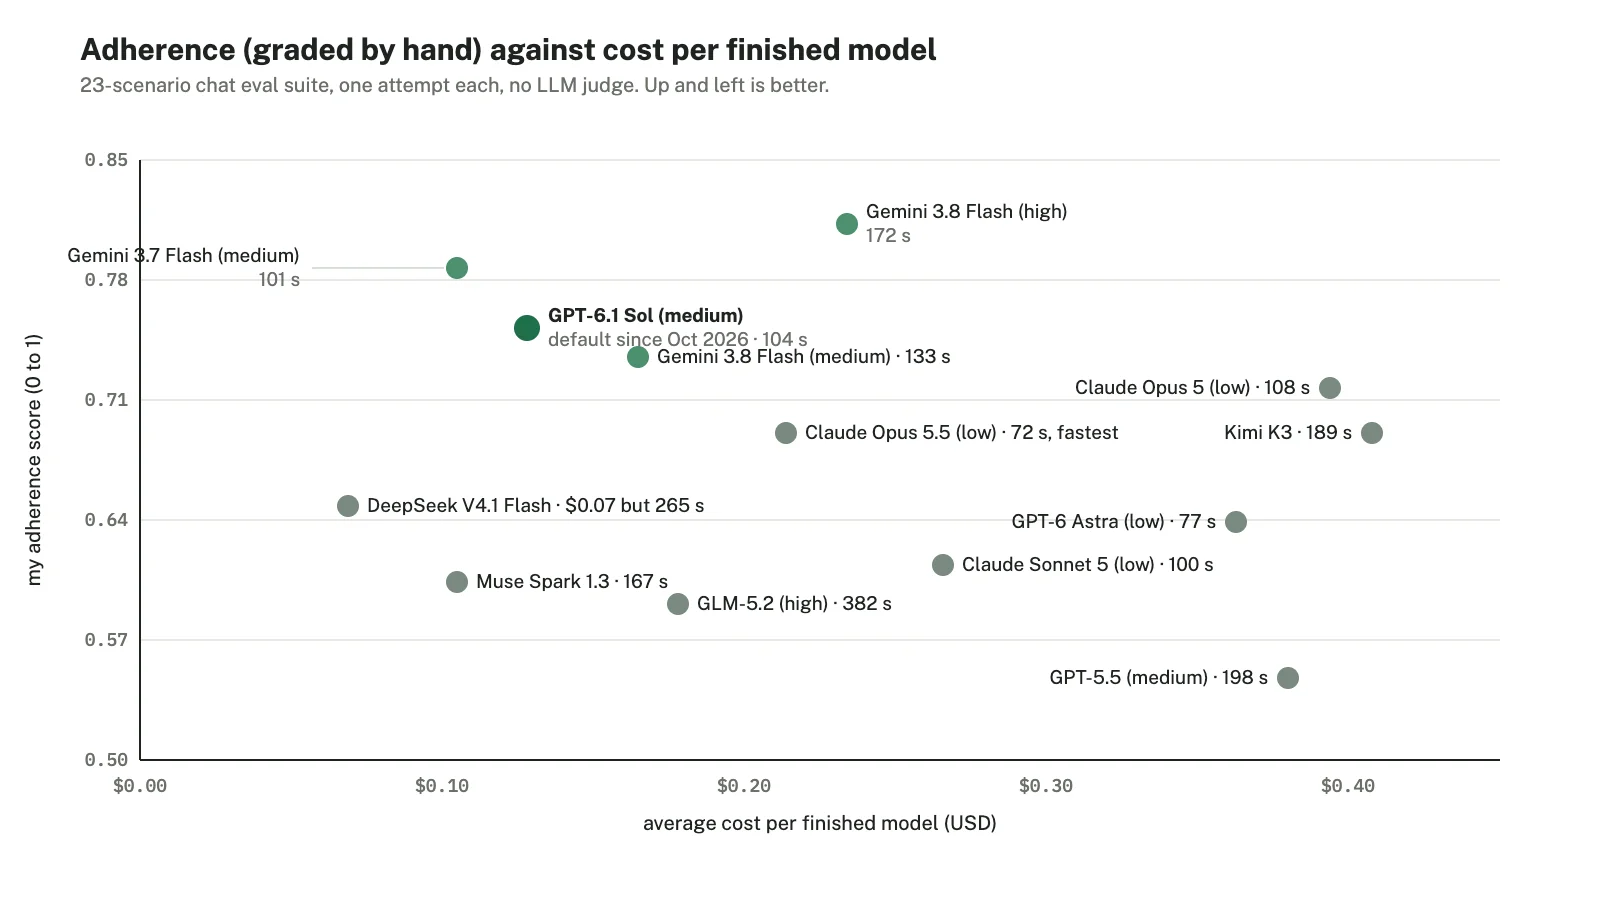
Chaque point ci-dessous correspond à un passage complet de la batterie, une tentative par scénario, noté à la main. Le coût est la moyenne par modèle terminé, nouvelles tentatives comprises. Le temps est la durée moyenne entre le prompt et le fichier.
| Modèle (raisonnement) | Fidélité | Vérifications réussies | Erreurs de code | Coût moyen | Temps moyen |
|---|
| GPT-6.1 Sol (medium)par défaut depuis octobre 2026 | 0,75 | 91 / 106 | 1 | 0,13 $ | 1 min 44 s |
| Gemini 3.8 Flash (high) | 0,81 | 87 / 106 | 8 | 0,23 $ | 2 min 52 s |
| Gemini 3.7 Flash (medium)par défaut d'août à septembre 2026 | 0,79 | 97 / 106 | 10 | 0,11 $ | 1 min 41 s |
| Gemini 3.8 Flash (medium) | 0,74 | 90 / 106 | 9 | 0,17 $ | 2 min 13 s |
| Claude Opus 5 (low, Anthropic en direct) | 0,72 | 87 / 106 | 1 | 0,39 $ | 1 min 48 s |
| Claude Opus 5.5 (low)le plus rapide | 0,69 | 93 / 106 | 10 | 0,21 $ | 1 min 12 s |
| Kimi K3 (low) | 0,69 | 84 / 106 | 8 | 0,41 $ | 3 min 09 s |
| DeepSeek V4.1 Flash (low)le moins cher | 0,65 | 89 / 106 | 13 | 0,07 $ | 4 min 25 s |
| GPT-6 Astra (low) | 0,64 | 93 / 106 | 1 | 0,36 $ | 1 min 17 s |
| Muse Spark 1.3 (medium) | 0,60 | 87 / 106 | 3 | 0,11 $ | 2 min 47 s |
| GPT-5.5 (medium)aucun modèle produit sur 5 scénarios | 0,55 | 71 / 106 | 3 | 0,38 $ | 3 min 18 s |
Une réserve, par souci d'équité : ces runs s'étalent de juin à septembre 2026, et les prompts, les skills et l'outillage autour de l'agent se sont améliorés entre-temps. Deux prompts (le support hexagonal et le crochet pour panneau perforé) ont été précisés juste avant les runs de GPT-6.1 Sol. Les modèles testés en dernier ont donc eu un banc d'essai un peu plus clément. Mais les écarts qui comptent, dans la suite, sont plus grands que cette dérive.
Pourquoi GPT-6.1 Sol plutôt que Gemini 3.8 Flash
À ne regarder que la colonne fidélité, c'est Gemini 3.8 Flash en raisonnement high qui gagne. C'est lui qui a produit les modèles que j'ai préférés (0,81). Mais son code a aussi planté huit fois sur 23 scénarios, il lui a fallu près de trois minutes par modèle, et il a coûté presque deux fois plus cher que GPT-6.1 Sol.
GPT-6.1 Sol, lui, n'a planté qu'une fois. Une seule, sur toute la batterie. Une erreur de code, ce n'est pas une statistique abstraite : c'est un utilisateur qui regarde tourner la roue de chargement pendant que l'agent répare son propre script, et chaque réparation, c'est un appel au modèle de plus. Pour quelqu'un qui lance sa première génération gratuite, je préfère Sol (0,75 de fidélité, 1 erreur, 0,13 $, 1 min 44 s) à un 0,81 assorti d'une chance sur trois de voir l'agent se reprendre sous ses yeux.
Il y a une deuxième raison, que la batterie ne capte qu'en partie. Sol construit des objets bien plus complexes que tout ce qui l'a précédé : assemblages de plusieurs pièces, boîtiers où chaque découpe tombe au bon endroit, mécanismes dont les pièces doivent s'aligner. Le prix à payer, c'est la créativité. Avec une demande floue, vous obtenez une pièce sobre, prise au pied de la lettre. J'ai détaillé ce compromis dans l'article sur le passage à Sol, prompts à l'appui.
Si vous faites tourner votre propre pipeline et que le coût est votre contrainte, je recommanderais encore Gemini 3.7 Flash en medium : meilleur taux de vérifications réussies du tableau (97 sur 106), 0,11 $ par modèle, et il a été notre modèle par défaut pendant deux mois. Face à Sol, il a perdu sur les erreurs de code (10 contre 1) et sur ce qu'il sait construire, pas sur le prix.
Ce qu'un an de benchmarks m'a appris
Plus de raisonnement aide rarement, et nuit souvent. En high, Gemini 3.7 Flash a fait tomber les erreurs de code au premier essai de 10 à 3, et il a quand même été moins bien noté qu'en medium, pour plus cher et plus lent. Claude Opus 5 en high a été pire qu'en low sur toute la ligne : 2,4 fois plus lent, 39 % plus cher, cinq erreurs de code au lieu de zéro, et deux scénarios coupés par la limite de dix minutes. Déjà en 2025, GPT-5 en medium battait le high pour deux fois moins cher. La réflexion supplémentaire part dans la réflexion, pas dans la pièce.
La passerelle n'est pas neutre. Le même Claude Opus 5, au même effort, a coûté 35 % de moins via l'API d'Anthropic que via OpenRouter. Il était moins cher dans 22 scénarios sur 23, pour une qualité identique. L'article sur Opus 5 décrit le test qui explique pourquoi.
Les erreurs de code en disent plus long sur ce que vit l'utilisateur que ma note de fidélité. La fidélité indique si la pièce finale est juste. Les erreurs de code indiquent combien de temps l'utilisateur a attendu, et combien d'appels au modèle j'ai payés pour en arriver là. Quand deux modèles sont à moins de 0,05 l'un de l'autre en fidélité, c'est la colonne des erreurs qui tranche.
Les classements publics contredisent ce tableau à chaque fois. En avril, Kimi K2.6 trônait en tête d'un classement ELO public consacré à la 3D et a fini dernier en conditions réelles, tandis qu'Opus 4.7, lent et cher sur le papier, l'a emporté haut la main. Cet article-là détaille les quatre façons dont les chiffres publics mentent. Rien depuis ne m'a fait changer d'avis.
Si vous voulez vérifier quoi que ce soit, tous les runs, y compris les plus moches, sont sur la page des évaluations, avec la transcription complète de chaque appel d'outil.
Les chiffres de novembre 2025
Voici ce que disait l'article à l'origine, sans retouche. Ces tests tournaient sur l'ancien pipeline en un seul passage (un prompt, une génération, pas de boucle d'agent), et c'est un juge IA qui notait la fidélité, pas moi. C'est pour ça que ces chiffres ne se comparent pas avec le tableau du dessus.
GPT-5 (7 août), GPT-5.1 (12 novembre) et Gemini 3 (19 novembre) étaient tous sortis en l'espace de quatre mois. J'ai lancé 84 générations sur chacun. Rien que dans les 24 heures qui ont suivi la sortie de Gemini 3, j'ai brûlé 6 millions de tokens dessus.
| Indicateur | Gemini 3 | GPT-5 | GPT-5.1 |
|---|
| Score pondéré | 0,555 | 0,501 | 0,467 |
| Taux de réussite | 79,76 % | 80,95 % | 67,86 % |
| Fidélité (juge IA) | 0,57 | 0,54 | 0,46 |
| Coût moyen | 0,14 $ | 0,18 $ | 0,26 $ |
| Temps moyen | 1 min 24 s | 3 min 26 s | 1 min 12 s |
| Coût total (84 générations) | 12,05 $ | 15,40 $ | 22,13 $ |
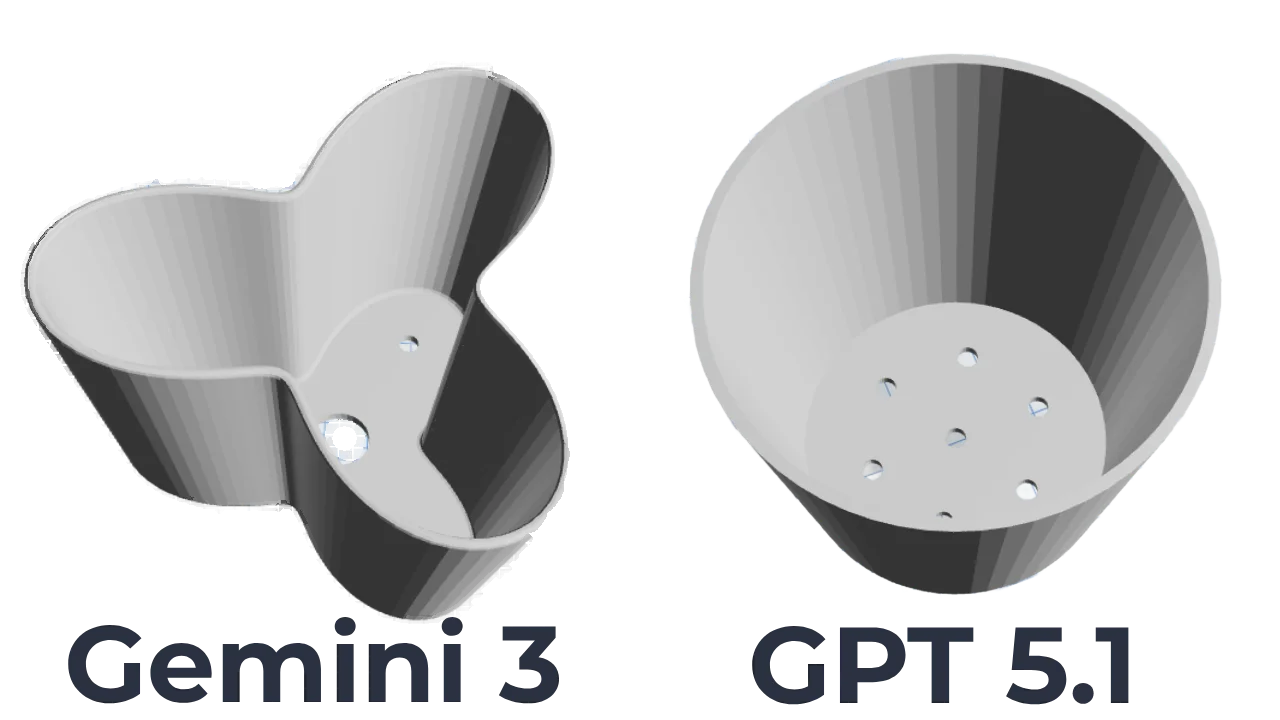
Gemini 3 l'emportait sur le score pondéré, la fidélité et le coût, et on sentait la différence. Quand je demandais « un pot empilable », les modèles précédents me rendaient un cylindre avec un rebord ; Gemini 3, lui, faisait un objet que j'aurais vraiment empilé. GPT-5.1 était rapide, mais il tournait sur le niveau prioritaire d'OpenAI, qui doublait son prix pour 20 à 30 % de vitesse en plus, et son taux de réussite tombait à 67,86 %. GPT-5 avait le meilleur taux de réussite, mais mettait plus de trois minutes par modèle.
Cliquez sur une image pour examiner le modèle.
Gemini 3 est devenu le modèle par défaut la semaine même. Il a tenu jusqu'à Gemini 3.1 en mars 2026, remplacé à son tour par Opus 4.7 en avril, puis par Gemini 3.6 Flash en juillet et Gemini 3.7 Flash en août. Le classement bouge vite, et le seul moyen de suivre, c'est de relancer la batterie encore et encore.
Vous voulez le prochain benchmark dès sa sortie ?
Ou essayez directement le modèle gagnant.